Encora Webinar: Cómo un DBA optimiza el rendimiento de SQL Server.
Roberto Carrancio – Líder de la línea de negocio DBA as a Service de Encora.
Encora Webinar: Cómo un DBA optimiza el rendimiento de SQL Server.
Bienvenidos a este Encora webinar en el que vamos a ver cómo un DBA optimiza el rendimiento de SQL Server.
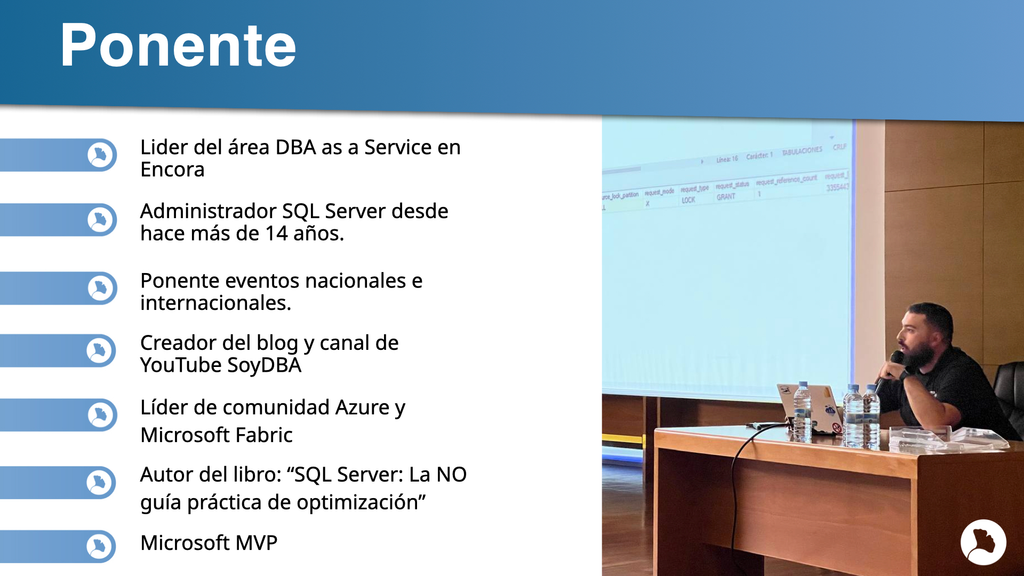
Antes de empezar presentarme para los que no me conocéis todavía. Yo soy Roberto Carrancio. Voy a ser vuestro ponente hoy. Soy el líder del área de DBA as Service en Encora.
Llevo en esto de la administración de SQL Server ya unos cuantos añitos. Ya va para 15.
Soy ponente normalmente en eventos tanto nacionales como internacionales.
También tengo un blog y un canal de YouTube donde podéis ver pues un poquito más técnicamente lo que hago. Y lidero comunidades de datos tanto de Azure como de Microsoft Fabric.
También he escrito un libro de SQL, de optimización de rendimiento de SQL Server., muy acorde con lo que vamos a hablar hoy.
Y todo esto pues me ha llevado también al reconocimiento por parte de Microsoft como “Most Valuable Professional” como MVP de Microsoft.
Ahora que ya sabéis un poco quién soy yo y por qué estoy aquí hablándoos de esto, pues vamos a ver qué es lo que vamos a ver.
1:14
Agenda: Cómo un DBA optimiza el rendimiento de SQL Server.
Encora Webinar: Cómo un DBA optimiza el rendimiento de SQL Server.
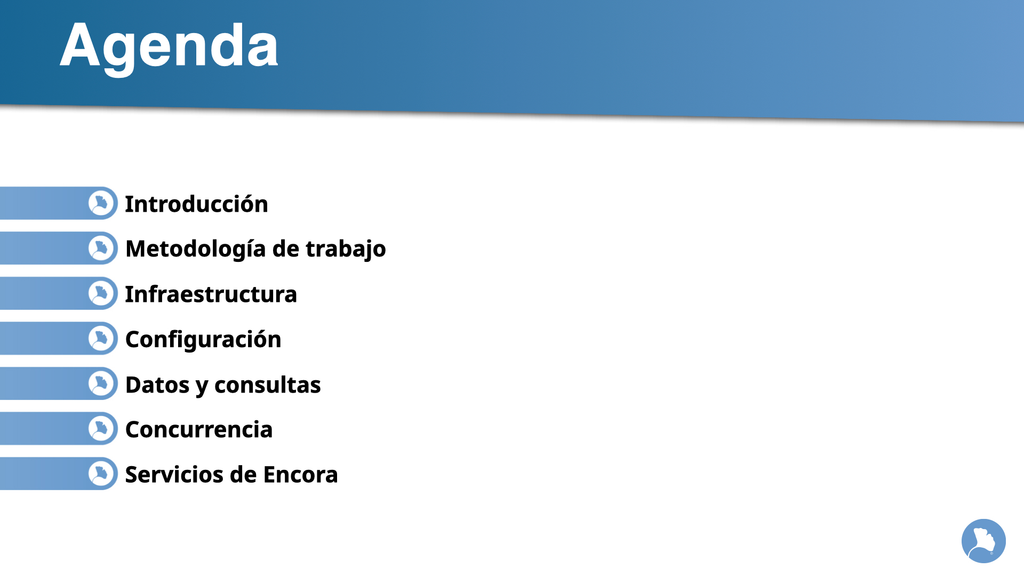
Introducción
Lo primero, vamos a hacer una pequeña introducción al tema.
Metodología de trabajo
Vamos a ver cuál es nuestra metodología de trabajo en Encora para este tipo de optimizaciones de rendimiento y afrontar problemas de rendimiento y mejoras de rendimiento.
Infraestructura
SQL Server desde el lado de la infraestructura.
Configuración
SQL Server desde el lado de la configuración también.
Datos y consultas
Por supuesto, SQL Server desde el lado de los datos y de las consultas.
Concurrencia
Obviamente las bases de datos no tienen una persona sola trabajando, tienen más, así que la concurrencia también es muy importante en SQL Server.
Servicios de Encora
Veremos por último esos servicios que os podemos ofrecer desde Encora para el rendimiento de SQL Server
y para muchos más.
Y con esto pasaríamos ya después a que hagáis vuestras preguntas.
1:58
Introducción: Cómo un DBA optimiza el rendimiento de SQL Server.
Encora Webinar: Cómo un DBA optimiza el rendimiento de SQL Server.
Vamos a empezar. Lo primero, ¿Por qué estamos aquí hablando de rendimiento? El rendimiento tiene implicaciones muy importantes.
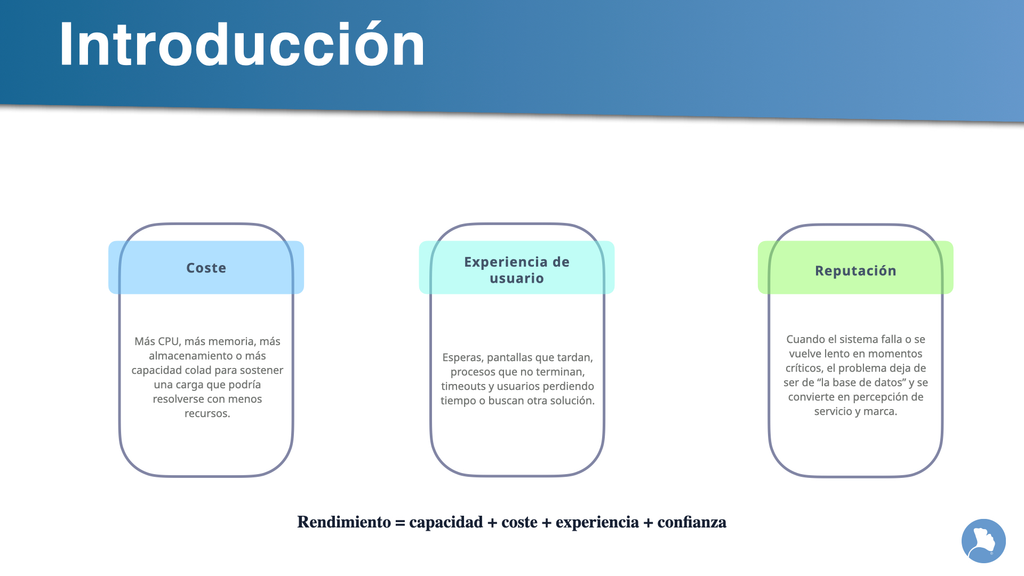
Coste
La primera, obviamente, es el coste, un peor rendimiento implica más consumo de CPU, más consumo de memoria, más necesidades de velocidad en acceso al almacenamiento y en definitiva más capacidad para sostener la carga que podría resolverse con mucho menos recursos.
Con lo cual todo esto tiene un impacto directo en el coste que va a tener nuestro servicio, sobre todo en esas cargas en la nube, que pagamos por capacidad.
Experiencia de usuario
Por otro lado, tenemos la experiencia de usuario y es algo que se deja pasar por alto muchas veces, pero que es importantísima. Esas esperas, esas pantallas que tardan 30 segundos en cargar, esos procesos que no terminan incluso llegan a dar time outs.
Entonces, al final tenemos a nuestra gente que está perdiendo el tiempo o directamente que terminan por buscar otra solución y dejar de usar las aplicaciones y esto si lo llevamos a la parte de fuera, a nuestros clientes, pues porque tenemos una tienda web, porque tenemos una aplicación, los clientes, al final lo que repercute es en nuestra imagen de marca y en nuestra reputación.
Reputación
Cuando el sistema falla y sobre todo en los momentos más críticos, la gente no va a ver un problema de base de datos, la gente no va a ver un problema de rendimiento de SQL Server.
Al final lo que va a ver es un problema de nuestra marca, de nuestra empresa. Entonces el rendimiento tiene implicaciones tanto de coste como de experiencia como de confianza de nuestros propios clientes.
Por eso es tan importante que nuestras bases de datos estén lo más optimizadas posibles y funcionen siempre de una manera muy ágil.
¿Cómo afrontamos esto desde la unidad de DBA as a service de Encora?
3:59
SQL Server está lento no vale: Cómo un DBA optimiza el rendimiento de SQL Server.
Encora Webinar: Cómo un DBA optimiza el rendimiento de SQL Server.
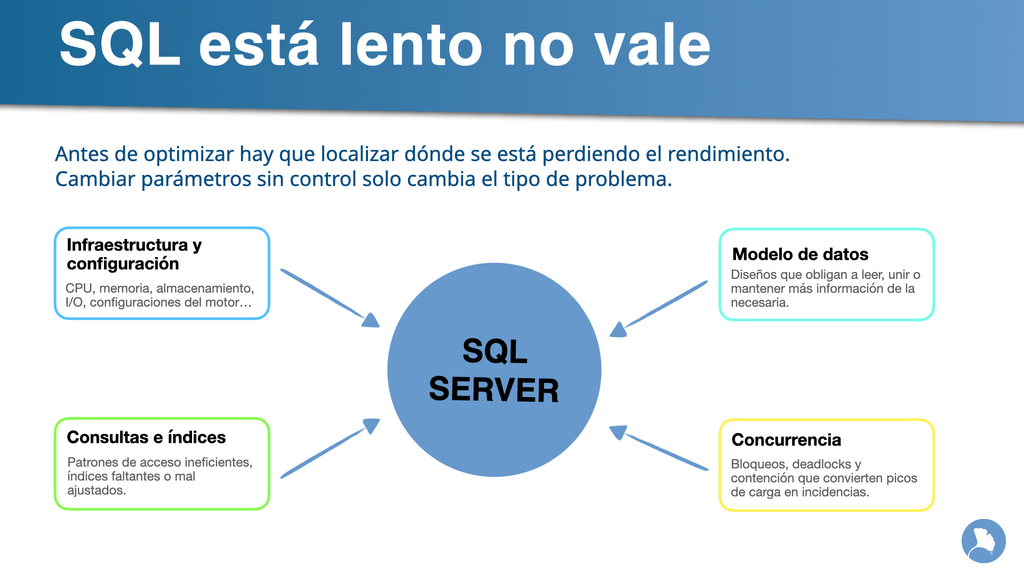
Obviamente decir SQL Server está lento no es una solución.
Antes de optimizar hay que localizar dónde se está perdiendo rendimiento.
Hay que ver dónde está el problema. Decir que está lento no nos dice nada. Puede haber muchos problemas, puede haber una combinación de problemas, puede ser que lo que es válido para otro servidor, incluso dentro de nuestra propia organización, no sea válido para este del que estamos hablando.
Porque cada servidor es un mundo, los datos son distintos, la forma en la que accedemos a ellos también.
Entonces tenemos que verlo desde distintos ángulos.
Infraestructura y configuración
Por un lado, está, por supuesto, la infraestructura y la configuración del servidor. Cómo tenemos dimensionada la CPU, la memoria, el almacenamiento, cómo lo tenemos configurado. Todo eso va a influir. Ahora lo vamos a ir viendo poco a poco.
Modelo de datos
El modelo de datos también importa. Porque si tenemos un modelo de datos que no está muy normalizado, que no está normalizado o que tiene una serie de malas prácticas, lo que nos va a obligar es a tener que hacer lecturas de más para poder encontrar el dato que estamos buscando.
Porque no hay una relación clara entre los datos, entonces tengo que estar haciendo consultas de más para saber qué dato es el bueno.
Consultas e índices
Por supuesto, las consultas y los índices son muy importantes.
Por el lado de las consultas hay una serie de patrones que se llaman antipatrones realmente, que es una serie de malas prácticas que hacen que, aunque la consulta nos esté devolviendo datos, no le está haciendo o no lo esté haciendo de la manera más eficiente posible.
Por eso es muy importante la optimización del código. Yo siempre he dicho que uno de los problemas de SQL Server es que una consulta mala funciona, porque si no funcionase nos obligaría a escribirla de una manera y solo habría una manera de escribir las consultas y de obtener los datos, pero no.
Hay muchas maneras de llegar al mismo resultado, pero no todas funcionan igual. Entonces, hay cosas que sí que son buenas prácticas que más o menos podemos tenerlas claras, pero muchas veces no nos queda otra que probar.
Probar con nuestros datos, porque lo que era bueno con muy pocos datos deja de ser bueno con muchos y lo que es bueno con muchos no es igual de óptimo con pocos datos.
Entonces, depende la volumetría de nuestros datos, depende toda nuestra configuración, todo lo que rodea al servidor, tendremos que hacerlo de una manera o de otra y nos lleva a que nunca hay que parar de optimizar. No por haber hecho una consulta que funciona realmente bien, nos podemos cruzar de brazos y decir, «Esto ya está hecho» y no volver a ello.
Muy relacionado con las consultas está el tema de los índices. Con las consultas y con el modelo.
Los índices al final lo que son, en resumidas cuentas, muy alto nivel sin bajar al barro, son unas copias de nuestra tabla más pequeñitas y con otro tipo de ordenación que nos permiten acceder a las columnas que queremos de una manera más rápida.
Indexaremos pues las consultas que vamos a las columnas que vamos a consultar, pero también debemos tener en cuenta no solo las que vamos a filtrar, sino las que vamos a leer. No van en el mismo sitio en el índice, pero hay que tenerlas en cuenta.
Concurrencia
Y por último, hay que tener muy en cuenta la concurrencia. Si este tema os interesa, el tema de la concurrencia da para un webinar por sí solo. Porque es un tema muy interesante.
Hay distintas formas de trabajar la concurrencia en SQL Server, distintos lo que lo que se llama el aislamiento, Entonces, podemos trabajar con bloqueos, podemos trabajar con snapshot, podemos trabajar en un nivel de aislamiento serializable, tenemos distintos métodos de aislamiento de las consultas que van a repercutir directamente en cuántos usuarios van a poder acceder a los datos a la vez y cómo.
Y eso al final es rendimiento, porque no nos tenemos que olvidar, y esto es muy importante, que en el rendimiento de las consultas no es solo el tiempo que el motor de base de datos tarda en procesar la consulta.
Que muchas veces creemos o miramos por encima. Decimos, «Vale, pues SQL Server tarda 2 minutos en procesar la consulta” Igual SQL Server tarda 10 segundos en procesar la consulta, pero el resto del tiempo hasta los dos minutos es lo que está esperando para poder procesar.
Porque hay otro usuario que tiene bloqueada la tabla porque no consigue CPU porque el servidor está saturado, porque no pue porque la memoria está saturada, porque el acceso a disco está saturado.
Entonces, tenemos que diferenciar muy bien lo que es tiempo de procesamiento de lo que es todo lo demás.
Entonces, hay distintos tipos de espera que tenemos que controlar, pero bueno, eso lo vamos a ir viendo a lo largo de este de este webinar.
8:47
Metodología DBA as a Service: Cómo un DBA optimiza el rendimiento de SQL Server.
Encora Webinar: Cómo un DBA optimiza el rendimiento de SQL Server.
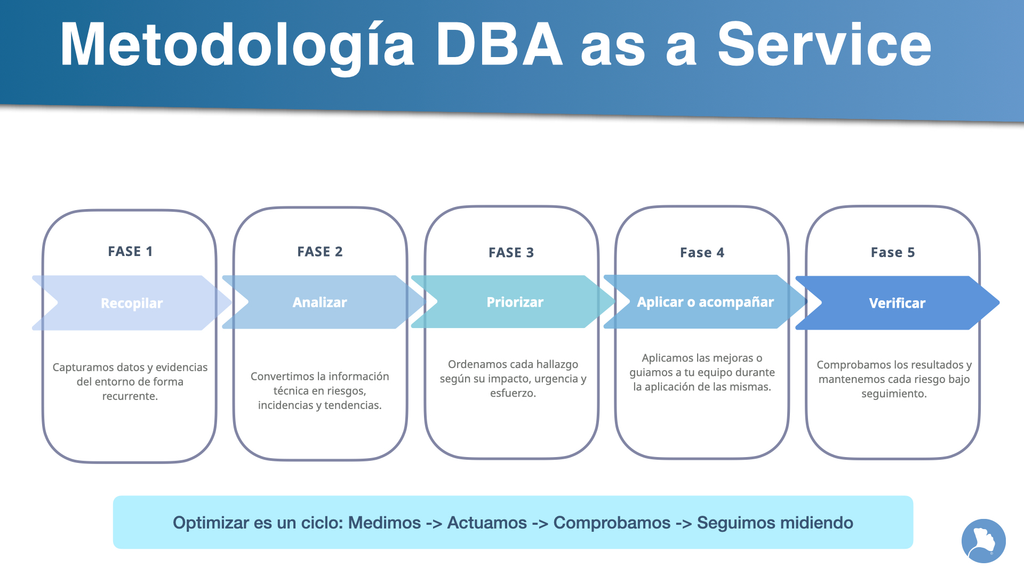
¿Cómo hacemos esto? En el anterior webinar os hablé de la metodología en el último paso, pero aquí sí que quería ponéroslo al principio para que entendáis cómo vamos a trabajar con todo esto.
Lo vamos a hacer por fases, en concreto cinco fases.
Fase 1 Recopilar
La primera va a ser la recopilación. Capturaremos los datos y todas las evidencias que podamos.
Fase 2 Analizar
Analizaremos esas evidencias que hemos capturado.
Fase 3 Priorizar
Priorizaremos las acciones porque seguramente haya muchas cosas que mirar.
Fase 4 Aplicar o acompañar
Con eso aplicaremos las mejoras o acompañaremos a los equipos que tengan que aplicar esas mejoras. ¿Por qué digo acompañaremos? Porque muchas veces cuando estamos hablando de cambios en el código no corresponde al DBA hacer esos cambios, sino que tiene que ser el desarrollador, que puede ser interno o incluso externo porque sea una aplicación de terceros. Hay que decirle al desarrollador, esto así está dando un mal rendimiento, hay que cambiarlo de esta otra manera.
Pero todo eso hay que decirlo. Entonces, no porque tengáis un CRM o un ERP de un proveedor que no podéis tocar el código, significa que no necesitáis un DBA. Ahí el DBA lo que va a hacer es detectar y daros todo lo necesario para que os podáis poner en contacto con el proveedor y solucionar la incidencia.
Fase 5 Verificar
Por último, verificaremos los resultados y en este punto empezaríamos otra vez con la fase de recopilación. Al final la fase de verificación no deja de ser otra vez la recopilación y el análisis. Cuando digo verificar me refiero a volver a recopilar todos los datos y volver a analizar. Ahí vamos a ver si lo que hemos hecho ha funcionado, pero también vamos a detectar cosas nuevas. Por ejemplo, os cuento un caso real.
Tenía yo un cliente que tenía muchos bloqueos, tenía muchos bloqueos y era el principal tiempo de espera de su servidor. Solucionamos esos bloqueos cambiando el nivel de aislamiento. Como os dije. ¿Qué pasó? Que en ese momento pasó a tener un cuello de botella en la CPU porque el servidor procesaba 20 consultas por segundo porque el resto estaban bloqueadas. En cuanto desbloqueamos esas consultas, el servidor pasó a procesar 2.000 peticiones por segundo.
Conclusión, nos dimos cuenta de que la CPU, que parecía que no era un problema, realmente sí lo era porque el servidor no estaba bien dimensionado para la carga de trabajo que tenía, pero había un problema anterior que no nos dejaba ver. Si nos hubiésemos quedado en la solución del primer problema y no hubiésemos vuelto a verificar, no habríamos detectado que había un nuevo problema. Entonces, como os digo, esto es cíclico.
Y arreglando una cosa empezamos a ver más lo mismo. Podemos ir cerrando el círculo, ¿no? Como se dice. Primero empezamos a mirar, por ejemplo, empezamos a mirar las consultas y empezamos a mirar todas las consultas que tardan más de un minuto. Cuando ninguna consulta tarda más de un minuto, no paramos. Empezamos a mirar las que tardan más de 30 segundos, después las que tardan más de 10 y así vamos optimizando, optimizando, optimizando.
De esa manera aplicamos esa priorización de la que hablábamos. Empezamos por lo más grave y luego vamos optimizando y seguimos y seguimos y seguimos. Además, como todos sabéis, las bases de datos están vivas.
Normalmente cambian tanto los datos como el código, pero aunque el código no cambie, que es inevitable, termina cambiando porque todo el software sufre actualizaciones, pero aunque el código no cambie, siempre van a ir modificándose los datos y eso significa que lo que valía ayer no tiene por qué valer mañana. Entonces, tenemos que estar continuamente mirando.
Para eso nos vamos a apoyar en una serie de herramientas, y vamos a tener ese control de cómo va siendo la tendencia del rendimiento. Como os decía, la optimización siempre es un ciclo.
13:02
Health Check: Cómo un DBA optimiza el rendimiento de SQL Server.
Encora Webinar: Cómo un DBA optimiza el rendimiento de SQL Server.
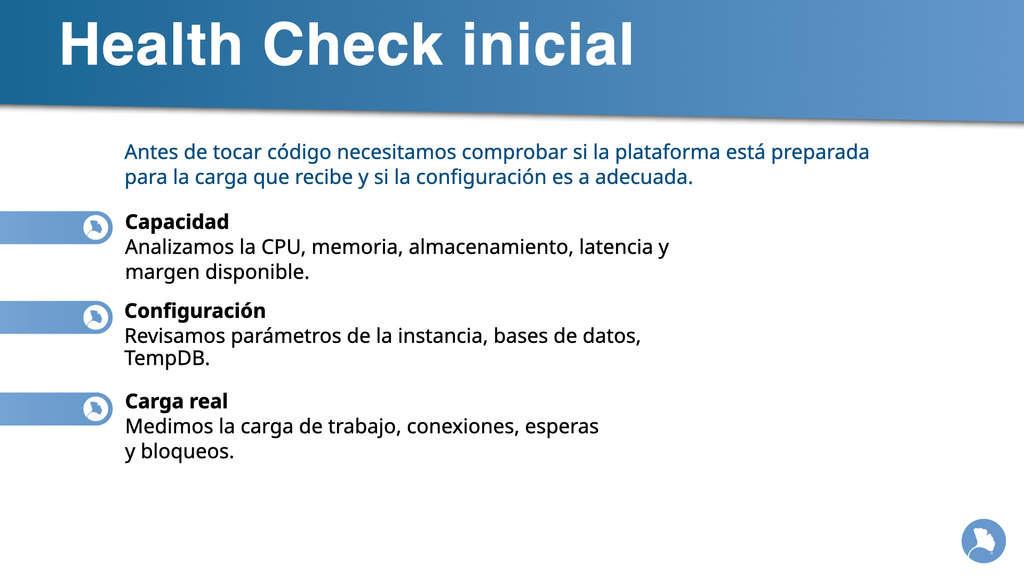
Antes de tocar código necesitamos comprobar si la plataforma está preparada para la carga que recibe y si la configuración es adecuada.
Entonces vamos a empezar por el primer paso, la toma de información. ¿Cómo vamos a empezar con esto? Vamos a empezar con un chequeo de salud del servidor. Antes de tocar el código, antes de cambiar una sola configuración, vamos a comprobar qué es lo que tenemos en el servidor, tanto de configuraciones como de infraestructura y de carga de trabajo.
Capacidad
Vamos a mirar, por supuesto, la capacidad del servidor. Vamos a ver qué CPU tiene, cómo está distribuida, vamos a ver la memoria, almacenamiento, qué latencias tiene en acceso a discos, y qué margen tenemos disponible.
Configuración
Vamos a mirar también qué configuraciones tiene. Las configuraciones tanto a nivel de la instancia como a nivel de las bases de datos de usuario como a nivel de las bases de datos, sobre todo TempDB de las bases de datos de sistema. Sabéis que TempDB es una base de datos muy crítica porque es de sistema y la usan todos los procesos de todas las demás.
Entonces es una base de datos muy crítica, con mucha concurrencia que hay que prestarle una especial atención.
Carga real
Por último, como os decía, vamos a medir la carga real de trabajo, las conexiones, las esperas, los bloqueos de los que hablaba antes. No es lo mismo un servidor que puede estar bien dimensionado para una carga de trabajo con 200 peticiones simultáneas que con 20.000 peticiones simultáneas. No es lo mismo. El servidor que nos valía para una cosa puede no valernos para otra. Lo mismo a medida que va creciendo el volumen de los datos.
Nosotros tenemos nuestro servidor, pero de repente vamos a hacer una campaña y esperamos que de aquí a final de año duplique el número de clientes, que ojalá estéis todos en esa situación. Pues antes de vernos en un problema de rendimiento, tendremos que analizar el servidor y decir, «Vale, pero estamos preparados para asumir esa carga de trabajo». Pues eso es lo que vamos a analizar.
14:47
Infraestructura: Cómo un DBA optimiza el rendimiento de SQL Server.
Encora Webinar: Cómo un DBA optimiza el rendimiento de SQL Server.
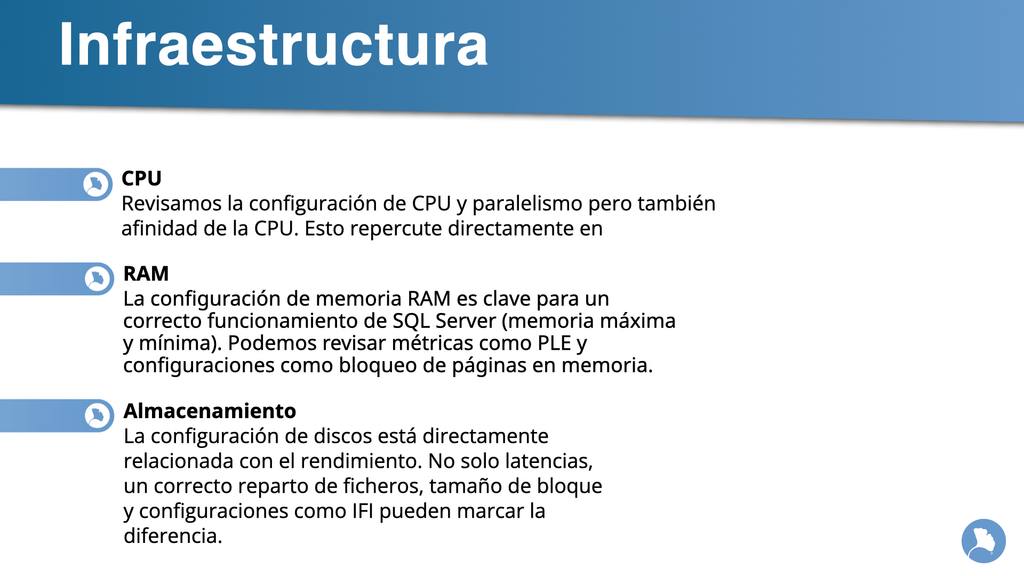
CPU
Por el lado de la infraestructura, como os decía, vamos a mirar la CPU. Una de las cosas claves, no solo cuántas CPU tenemos, no solo cuántos núcleos tenemos, a qué velocidad van esos núcleos, cómo están configurados.
Porque sabéis que sobre todo en SQL Server Standard tenemos la limitación que no admite más de cuatro sockets, admite hasta 24 cores, pero no admite más de cuatro sockets, con lo cual tenemos que ver cómo están posicionados el número de núcleos respecto al número de sockets de la CPU en sobre todo en máquinas virtuales. Tenemos que revisar la configuración del paralelismo, pero también podemos bajar al nivel de revisar la afinidad de la CPU.
Esto es un tema muy avanzado en el que no vamos a entrar. Pero quiero que sepáis que la infraestructura física que hay por debajo en el servidor, si hay un procesador o hay dos con varios núcleos, pues luego esos núcleos cuando los pasamos a una máquina virtual por encima tienen que estar relacionados porque cada uno de sus núcleos tiene una zona de memoria a la que accede más rápido que si tiene que acceder a la otra.
Entonces esa afinidad tenemos que tenerla muy controlada.
RAM
Hemos adelantado la memoria, por supuesto, la memoria es clave para SQL Server. Existen dos parámetros principales que podemos configurar en SQL Server, que son la memoria máxima y la mínima. La mínima en servidores dedicados yo no la tocaría, pero la máxima sí. La máxima siempre hay que ajustarla.
No ajustar la memoria máxima puede llevarnos a que el servidor de SQL Server empiece a consumir memoria, consumir memoria, consumir memoria, hasta dejar al sistema operativo sin memoria y provocar un fallo a nivel del sistema operativo. O incluso si tenemos un bloqueo de páginas de memoria que no las libera después y estamos en sistemas virtuales, puede llegar a afectar a los vecinos de ese hipervisor. A otros servidores que corren en el mismo hierro físico, ¿no?
Entonces es crítico tener bien configurada la memoria. Luego veremos, nos apoyaremos en métricas como el PLE, que es la esperanza de vida de una página de datos en memoria. Configuraciones como el bloqueo de páginas en memoria de la que os hablaba, que puede ser muy beneficiosa en algunas situaciones, pero muy poco beneficiosa, muy peligrosa en otras, y veremos a ver cómo vamos jugando con eso.
Todo esto son configuraciones que tiene SQL Server porque no todos los servidores son iguales como hablábamos. Entonces, como os decía, hay que adaptarlas siempre a vuestro caso de uso.
Almacenamiento
Por último, en la infraestructura tenemos el almacenamiento. La configuración de los discos está directamente relacionada con el rendimiento. Aquí hablamos no solo de latencias, sino de repartir correctamente los ficheros. Es una buena práctica, ya sabéis, tener los datos en un disco, el log en otro disco, TempDB en un disco dedicado.
Pero aparte de eso, también es una buena práctica formatear los discos con un tamaño concreto de bloque para que sea lo más óptimo para el uso que hace SQL Server del almacenamiento. Entonces, esos discos tienen que estar formateados de una manera en concreto. Lo mismo el reparto.
Lo ideal sería tener los ficheros de datos en un disco, los ficheros de log en otro y TempDB como os decía, pero esto si nos lo llevamos a las cabinas de almacenamiento, pues ahí hay volúmenes virtuales con esos discos físicos en los que tendríamos que intentar garantizar la máxima separación posible. Si luego separamos incluso de controladora, pues mucho mejor. Al final todo eso son cuellos de botella que nos quitamos.
No en todos los casos es posible, pero siempre que sea posible todas estas cosas hay que tenerlas en cuenta. Luego hay una serie de configuraciones. Como es IFI, el Instant File Initialization. La inicialización instantánea de ficheros que son o marcan una diferencia clave, mejor dicho, cada vez que un fichero de datos tiene que crecer.
Lo ideal, como vamos a ver más adelante, es tener configurado el servidor previamente con el almacenamiento que vamos a necesitar para que los crecimientos cuando haya que hacerlos, se hagan en ventanas de mantenimiento controladas, pero siempre puede pasar que un fichero de datos necesite crecer.
Y cuando un fichero de datos necesita crecer, el hecho de tener que poner todos los bits a cero o no ponerlos porque tienes habilitado el Instant File Initialization puede marcar la diferencia y ahí se pueden ir varios segundos en esa consulta de escritura que hace crecer el fichero.
19:42
Configuraciones: Cómo un DBA optimiza el rendimiento de SQL Server.
Encora Webinar: Cómo un DBA optimiza el rendimiento de SQL Server.
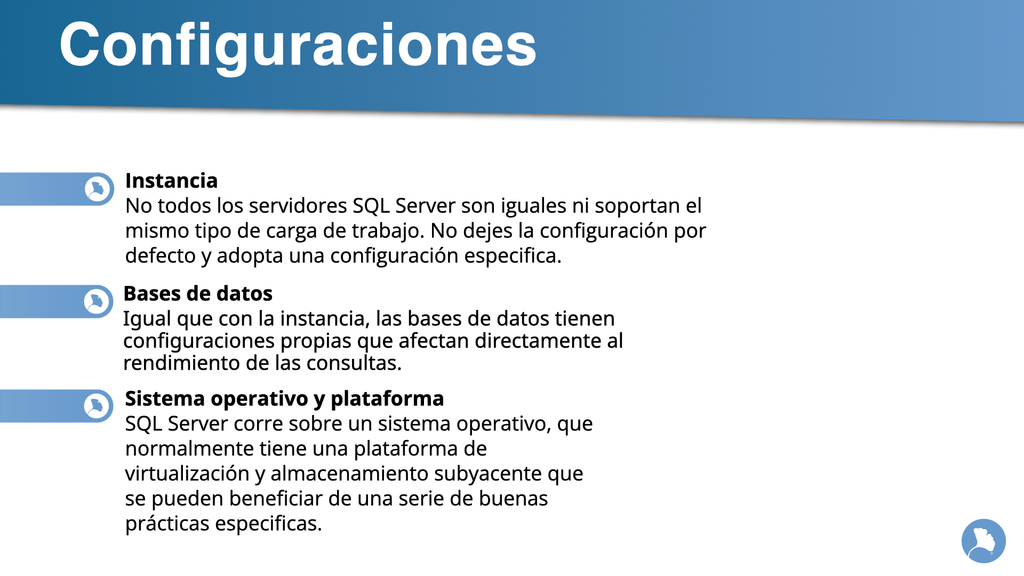
Instancia
Configuraciones a nivel de instancia. No todos los servidores son iguales, no soportan el mismo tipo de carga de trabajo. Con lo cual toda la configuración por defecto que viene en SQL Server, pues hombre, es por defecto y nos puede servir en un momento dado en un servidor pequeñito, con poca carga de trabajo. Está pensado para eso.
Pero en cuanto nuestro servidor crece, en cuanto el volumen de usuarios crece, necesitamos adoptar una configuración específica para nuestro tipo de datos, cómo están distribuidos los datos. Tenemos que tener en cuenta los patrones de acceso, si las consultas están almacenadas en procedimientos almacenados en SQL Server o si son consultas ad hoc. Hay un montón de configuraciones, decenas y decenas de ellas que tenemos que adaptar a nuestro servidor y a nuestros casos de uso.
Bases de datos
Y luego, cuando hemos terminado con todas las configuraciones de la instancia, vamos a pasar a revisar todas las configuraciones de base de datos, porque las bases de datos también tienen configuraciones propias que van a afectar directamente al rendimiento de las consultas.
Sistema operativo y plataforma
Y por supuesto, todo esto corre sobre un sistema operativo y una plataforma que también tienen que estar optimizados. No, no os digo nada, pero la guía de despliegue de un servidor Windows para SQL que ofrece VMware es de 94 páginas. Es un PDF de 94 páginas.
O sea, realmente hay mucho, mucho que hacer en todo lo que está por debajo y ahí solo estamos hablando de plataforma, no estamos hablando de configuraciones en el sistema operativo como las configuraciones de rendimiento del sistema operativo, por ejemplo, como el Instant File Initialization, como esos permisos del sistema operativo que tiene que tener la cuenta de servicio para que funcione de la mejor manera y luego ya nos metemos, ¿sí?, en el servidor SQL Server y luego la base de datos.
Hay mucho, mucho, mucho que revisar.
21:42
Datos y consultas: Cómo un DBA optimiza el rendimiento de SQL Server.
Encora Webinar: Cómo un DBA optimiza el rendimiento de SQL Server.
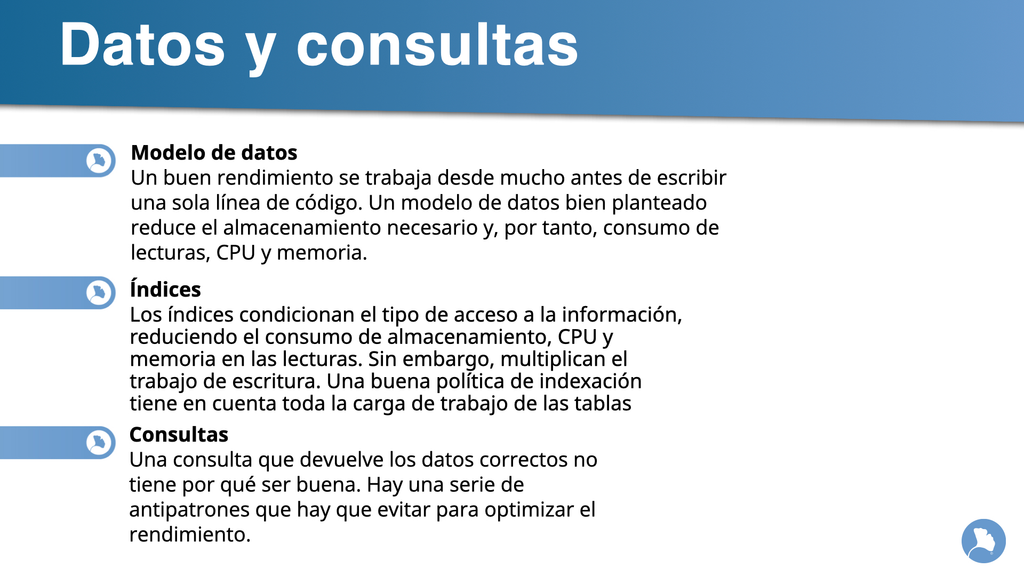
Modelo de datos
Una vez que las configuraciones las tenemos pulidas, llega el momento de hablar de datos y de consultas. El modelo de datos es importantísimo. De nada nos sirve tener el mejor servidor del mundo si luego nuestras consultas y nuestros datos no están bien. Y nuestras consultas nunca van a poder estar bien si los datos no están bien modelados. Con lo cual, el buen rendimiento del servidor se trabaja desde mucho antes de empezar a escribir código.
Desde el momento en el que estamos planteando vamos a desarrollar una aplicación, ya tenemos que pensar cómo vamos a modelar los datos para que sea escalable y a medida que crezca no tenga problemas. En todo esto os podemos acompañar, a vosotros y a vuestros equipos de desarrollo, para todas estas decisiones.
Índices
Por supuesto, los índices. Nosotros cuando estamos desarrollando, cuando estamos pensando en el modelo de datos, cuando estamos empezando a pensar nuestra aplicación y cómo va a acceder a los datos, en función de esos accesos a los datos, tenemos que diseñar los índices. No podemos diseñar los índices si no sabemos el tipo de acceso que vamos a hacer a los datos.
Es verdad que el motor de SQL Server cuando nosotros ejecutamos una consulta nos puede llegar a sacar un warning, una advertencia y decir, «Para esta consulta falta un índice.» Pero eso no significa que ese índice sea el más beneficioso, ni siquiera que no sea contraproducente, porque el índice que favorece una consulta puede no favorecer a las demás.
Entonces, tenemos que tener esa visión en conjunto de las consultas que van contra la base de datos, de los patrones de acceso a los datos para diseñar los mejores índices.
Como veis, todo esto se tiene o se debería diseñar desde esas primeras fases de modelado, cuando todavía no has empezado ni siquiera a escribir una línea de código ni a meter un solo dato, pero a posteriori se van a ir ajustando sobre todo el tema de los índices a medida que los datos crecen, a medida que los patrones de acceso cambian porque las aplicaciones, como decíamos, están vivas igual que los datos, pues todo eso se va ajustando.
Entonces, los índices hay que hacer continuamente o periódicamente, mejor dicho, una revisión de qué uso tienen, cuáles se usan más, cuáles se usan menos, cuáles directamente no se usan, cuáles faltan y ir ajustándolo continuamente. Quedaros con esto. No todos los índices que os propone SQL Server hay que crearlos porque SQL Server calcula el mejor índice para esa consulta, pero no tiene en cuenta todas las demás porque no puede tenerlo en cuenta.
Esta recomendación la saca viendo una consulta y además solo saca un índice por consulta y a lo mejor esa consulta necesita cinco índices. Entonces hay que tener una visión más global.
Consultas
Por supuesto, las consultas. Como os decía en la introducción, que una consulta devuelva datos no significa que sea una buena consulta y hay que evitar una serie de antipatrones. Seguro que si os digo no uséis SELECT * lo habéis oído todos, pero si os digo no uséis funciones de conversión en los filtros, en el WHERE.
Si os digo que un EXISTS rinde mejor que un IN cuando el volumen de datos es muy grande y que, por supuesto, un IN y un EXISTS rinden mejor que un JOIN, pues también vale, hay una serie de patrones que son mejores o peores. Fijaros, os he dicho tres formas de filtrar datos.
Dos rinden mejor que la tercera, pero hay una que cuando los datos crecen mucho, mucho, mucho, todavía rinde aún mejor y se nota más en el NOT EXISTS y el NOT IN que en el EXISTS y el IN. Pero como siempre, hay que probarlo. Siempre probar, probar y probar cada una de las formas de acceso y comparar.
25:27
Concurrencia: Cómo un DBA optimiza el rendimiento de SQL Server.
Encora Webinar: Cómo un DBA optimiza el rendimiento de SQL Server.
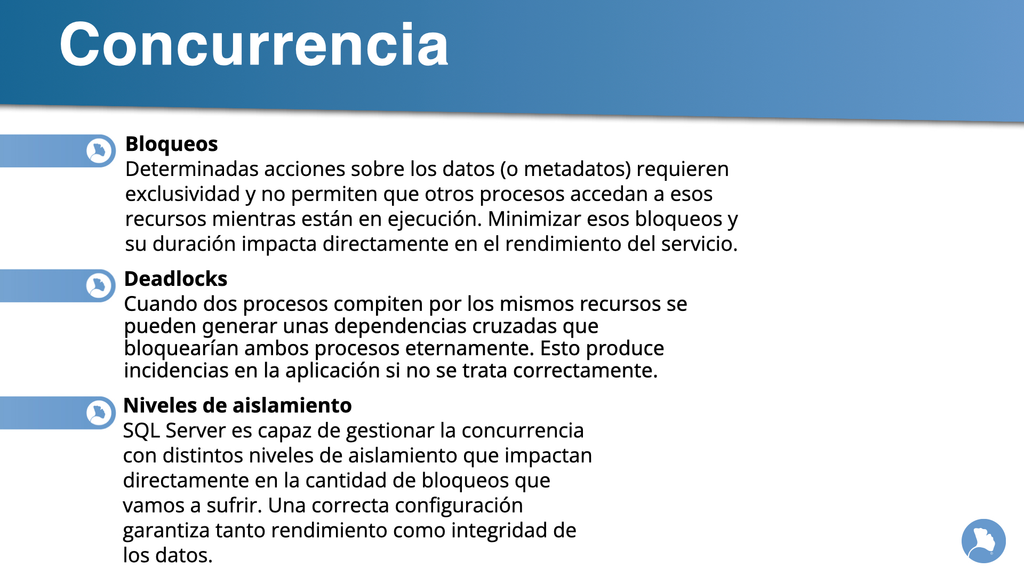
Bloqueos
Una vez que las consultas están bien, tenemos que fijarnos en la concurrencia. Lo que hablábamos de los bloqueos, si una consulta está leyendo datos, nadie más va a poder escribir sobre esa tabla porque hay una lectura por defecto en SQL Server. Luego hay mecanismos para cambiar esto. Pero hay ciertas acciones que bloquean los datos. Pero no solo los datos, también los metadatos.
¿Recordáis cuando os he hablado de TempDB y os he dicho que es crítica porque tiene mucha concurrencia, porque todos los procesos terminan usando TempDB por una cosa o por otra? Pues si tengo 94 bases de datos o 95 bases de datos o 96, me da igual, tengo 90 y muchas bases de datos, pero todos los procesos acceden a una sola temporal porque es lo que hay, pues esa es muy crítica. Y ahí también hay bloqueos.
Y hay bloqueos en las tablas de sistema, por ejemplo, de cuando se crea una tabla. No puedo crear una tabla temporal porque hay otro creando otra tabla temporal y en ese instante hay una colisión. Hay colisiones, a medida que crece la concurrencia se ve más y cuando crece el volumen de los datos se ve más. Entonces hay que tener mucho cuidado con los bloqueos.
Deadlocks o interbloqueos
Un caso extremo de bloqueos son los interbloqueos o los deadlocks. Dos procesos que compiten por los mismos recursos. El primero no puede terminar porque depende de un recurso que tiene bloqueado el segundo, pero es que el segundo no puede terminar porque necesita de un recurso que tiene bloqueado el primero. Esto no terminaría nunca y al final lo que pasa es que el motor de base de datos elige uno de los dos procesos y lo termina.
Se llama matar el proceso. Mata ese proceso de manera que el otro pueda terminar. ¿Cuál mata? Pues el que menos coste de rollback tenga, pero esto si no lo tratamos correctamente en el lado de la aplicación, si no tenemos una lógica de reintentos, nos va a generar una incidencia porque nos va a dar un error de que la transacción ha sido abortada por parte del motor de base de datos. Entonces, ¿qué tenemos que hacer?
Pues la recomendación normal es acceder a los datos siempre de la misma manera, en el mismo orden para no generar esos patrones que uno necesita de otro y otro necesita de uno. Otra de las cosas que tenemos que hacer, igual para los bloqueos que para los interbloqueos, es optimizar lo más posible nuestras consultas. Si una consulta tarda un segundo, es mucho más probable que genere un bloqueo que una consulta que tarda 1 milisegundo.
Va a generar los mismos bloqueos sobre los datos, porque al final hay que diferenciar bloqueo de contención. El bloqueo siempre se produce. La consulta coge el recurso y lo bloquea, pero nosotros no notamos esa contención hasta que otro proceso no intenta acceder a ese recurso.
Pues si estamos durante 1 milisegundo con el proceso bloqueado, con el recurso bloqueado o estamos durante un segundo con el proceso bloqueado, la cantidad de otros procesos que pueden necesitar de ese recurso pues crece exponencialmente, ¿no? Y a más tiempo, más bloqueos.
Niveles de aislamiento
También jugamos con los niveles de aislamiento. Como os comentaba, hay varios niveles. Esto da para un webinar por sí mismo. Los niveles de aislamiento en el que podemos ver cómo funcionan los bloqueos, cómo funcionan los snapshot y cómo funcionan los bloqueos optimizados nuevos que se han introducido en SQL Server 2025 y en Azure SQL Server desde aproximadamente febrero de 2025 o así. Entonces, pues hay cositas interesantes que más adelante podemos tratar si os interesa ese tema.
29:12
Servicios de Encora: Cómo un DBA optimiza el rendimiento de SQL Server.
Encora Webinar: Cómo un DBA optimiza el rendimiento de SQL Server.
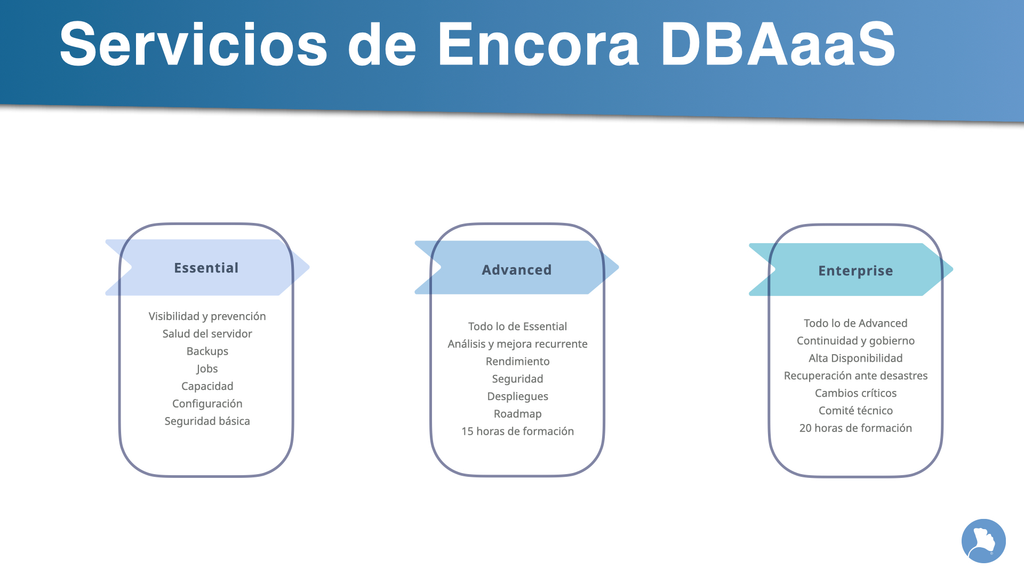
Servicios que os ofrecemos desde Encora. Pues nosotros tenemos tres niveles de servicio.
Essential
Visibilidad y prevención. Salud del servidor. Backups. Jobs. Capacidad. Configuración. Seguridad básica.
Tenemos un nivel Essential en el que vamos a tener esa visibilidad y esa prevención de la salud del servidor. Vamos a verificar las copias de seguridad, vamos a verificar los procesos que tenéis programados, toda la capacidad, la configuración y la seguridad básica. Pero en este nivel Essential no vamos a entrar en lo que es el rendimiento propiamente de las bases de datos.
Obviamente vamos a decir, hay un problema de configuración y sería más óptimo de la otra manera, pero no vamos a analizar en este sentido.
Advanced
Todo lo de Essential. Análisis y mejora recurrente. Rendimiento. Seguridad. Despliegues. Roadmap. 15 horas de formación.
Para hablar de rendimiento nos tendríamos que ir al nivel Advanced. En el nivel Advanced que os vamos a ofrecer, tenemos todo lo de Essential y vamos a hablar ya de rendimiento, vamos a hablar de seguridad, despliegue, roadmap y aparte vamos a tener 15 horas de formación porque como os decía, es muy importante tener esos conocimientos de cómo modelar los datos, de cómo escribir las consultas para que sean lo más óptimas posible.
Entonces, dentro del nivel Advanced os ofrecemos 15 horas de formación al año para que vuestros equipos de desarrollo puedan tener esa formación con nosotros y poder mejorar vuestra forma de escribir las consultas.
Enterprise
Todo lo de Advanced. Continuidad y gobierno. Alta disponibilidad. Recuperación ante desastres. Cambios críticos. Comité técnico. 20 horas de formación.
Y por último tenemos un nivel Enterprise que incluye todo lo que tiene el Advanced y está pensado para casos en los que la alta disponibilidad es un requisito, la continuidad, gobierno de datos, recuperación ante desastres, cambios críticos. Este incluye todo eso y aparte 20 horas de formación en vez de 15.
30:47
Otros servicios: Cómo un DBA optimiza el rendimiento de SQL Server.
Encora Webinar: Cómo un DBA optimiza el rendimiento de SQL Server.
Auditorías. Formación. Diseño de arquitectura. Health Check. Diseño DRP. Go to Cloud. Diseño de bases de datos.
¿Qué más servicios ofrecemos? Pues hacemos auditorías de servidores, formación a medida, tenemos diseño de la arquitectura, los Health Check de los que hemos hablado antes también los podemos hacer a petición aunque no haya un servicio recurrente, diseñar el plan de recuperación ante desastres, migraciones a la nube, diseñar esas bases de datos, como os decíamos que es importante definir la base de datos desde el minuto uno, pues también os acompañamos en eso.
Migraciones cuando queréis cambiar un servidor por otro, actualizaciones de versión, lo que sea, y por último el acompañamiento a desarrolladores.
31:27
Conclusión: Cómo un DBA optimiza el rendimiento de SQL Server.
Encora Webinar: Cómo un DBA optimiza el rendimiento de SQL Server.
Entonces, ¿qué conclusión podemos sacar de este webinar? Pues la pregunta no es si SQL Server funciona o si me está devolviendo los datos correctos. La pregunta es, ¿cuánto rendimiento nos estamos dejando por el camino, por nuestra configuración, por nuestro modelado, por nuestro patrón de acceso a los datos y cuánto nos está costando ese rendimiento? Y luego pues que desde DBA as a Service de Encora os podemos acompañar en todo esto. Y hasta aquí la sesión de hoy.
Espero que os haya gustado este Encora Webinar: Cómo un DBA optimiza el rendimiento de SQL Server. Nos vemos en el siguiente.